
Contenido del artículo
Resumen
La pandemia de COVID-19 ha causado infecciones generalizadas, muertes y cuantiosas pérdidas económicas. Los esfuerzos de desarrollo de vacunas han dado lugar a candidatos autorizados que reducen las hospitalizaciones y la mortalidad, aunque la aparición de variantes sigue siendo motivo de preocupación. El Perú sufrió un impacto considerable debido a las deficiencias de su sistema de salud. En este estudio se empleó la regresión logística para modelar matemáticamente la dinámica de la COVID-19 en el Perú a lo largo de tres años y se evaluaron las correlaciones entre casos, muertes y personas vacunadas. Se estimó el tiempo crítico (tc) para los casos (627 días), las muertes (389 días) y las personas vacunadas (268 días), en los cuales se alcanzaron los valores de velocidad máxima. Se identificaron correlaciones negativas entre las personas vacunadas y los casos (−0.40) y entre las personas vacunadas y las muertes (−0.75), lo que sugiere relaciones recíprocas entre esos pares de variables. Además, las pruebas de causalidad de Granger determinaron que la dinámica de la población vacunada puede utilizarse para pronosticar el comportamiento de las muertes (valor p < 0.05), lo que evidencia el impacto de las vacunaciones contra la COVID-19. Asimismo, el coeficiente de determinación (R2) indicó una representación robusta de los datos reales. Tomando el contexto peruano como caso de ejemplo, las proyecciones del modelo logístico sobre casos, muertes y vacunaciones aportan información crucial sobre la pandemia, orientan las estrategias de salud pública y reafirman el papel esencial de las vacunaciones y de la distribución de recursos para combatir eficazmente la COVID-19.
1. Introducción
La pandemia de la enfermedad por coronavirus 2019 (COVID-19) comenzó en Wuhan, China, en diciembre de 2019 [1]. Esta enfermedad es causada por el coronavirus 2 del síndrome respiratorio agudo severo (SARS-CoV-2). En la primera semana de la pandemia, los casos asintomáticos apenas alcanzaron el 1%. Entre las personas infectadas, el 81% presentó síntomas leves, el 14% cuadros graves y el 5% cuadros críticos o mortales [2]. Así, desde su aparición, este virus se ha propagado rápidamente por todo el mundo y ha causado más de 676 millones de infecciones, 6.8 millones de muertes, la administración de 13.3 mil millones de dosis de vacunas en total y billones de USD en pérdidas económicas [3, 4].
Esta enfermedad presenta algunas características particulares que han favorecido su propagación y su impacto catastrófico: (1) el agente etiológico, un virus de ARN, dotado de mecanismos evolutivos como una alta tasa de mutación y la recombinación genética [5]; (2) su largo periodo de incubación, que permite que las personas infectadas asintomáticas transmitan el virus [6]; (3) individuos susceptibles con un mayor riesgo de letalidad, entre ellos los adultos mayores, las personas inmunosuprimidas y las personas con enfermedades subyacentes [7]; (4) diversas fuentes de contagio, como las gotitas expulsadas al estornudar o toser y el contacto con objetos contaminados o su ingestión [8].
Desde los primeros reportes de un aumento de la transmisión comunitaria, el desarrollo de vacunas contra la COVID-19 ha sido un esfuerzo global en el que han participado tanto el sector público como el privado. En consecuencia, actualmente existen 382 candidatos vacunales, de los cuales 199 se encuentran en desarrollo preclínico y 183 en fase clínica [9]. El carácter de emergencia de la pandemia ha impulsado el desarrollo de varias plataformas vacunales, que incluyen vacunas clásicas (es decir, de virus vivo atenuado y de virus inactivado) y vacunas de nueva generación (p. ej., subunidades proteicas, vectores virales, ADN, ARN, partículas similares a virus) [10].
Los candidatos vacunales que superaron con éxito las evaluaciones preclínicas y clínicas y que fueron autorizados para uso de emergencia han reducido significativamente las hospitalizaciones y las tasas de mortalidad [11]. Sin embargo, las diferencias en la eficacia de las vacunas y la gran capacidad mutacional del SARS-CoV-2 han permitido la aparición de variantes de preocupación con capacidad de evasión inmunológica, lo que ha dado lugar a nuevas olas de infección [12].
El Perú fue uno de los países más afectados por la pandemia, debido a las deficiencias de su sistema hospitalario, y presentó la razón de letalidad por infección (IFR) más alta [13]. El número de infecciones confirmadas supera los 4.5 millones, mientras que las muertes superan las 220,000. Las vacunas utilizadas en el Perú son CoronaVac, AstraZeneca, Pfizer, Jansen y Moderna. Se han administrado más de 89.5 millones de dosis de vacunas, y más de 28.6 millones de personas cuentan con el esquema de vacunación completo [3].
El modelamiento matemático es una herramienta poderosa que se utiliza para estudiar la propagación de la COVID-19 en muchos países. Los modelos matemáticos pueden predecir cómo se propagará la enfermedad a lo largo del tiempo mediante el seguimiento del flujo de individuos entre distintos compartimentos, como susceptibles, infecciosos, recuperados y fallecidos. Cada uno de estos tipos de modelos tiene sus fortalezas y debilidades [14]. Los modelos SIR (susceptibles–infectados–recuperados) son relativamente sencillos de entender y pueden utilizarse para realizar predicciones rápidas. Sin embargo, deben considerar toda la complejidad de la propagación de la enfermedad [15]. Los modelos SEIR (susceptibles–expuestos–infectados–recuperados) son más complejos, pero pueden ofrecer una imagen más precisa de cómo se propaga una enfermedad [16, 17]. Los modelos SEIRD (susceptibles–expuestos–infectados–recuperados–fallecidos) son extensiones de los modelos SEIR que añaden un compartimento para los individuos que han muerto a causa de la enfermedad. Esto permite que los modelos SEIRD sigan todo el curso de una epidemia, desde las etapas iniciales hasta el final [18, 19].
Además, los modelos logísticos son modelos de ajuste de curvas que pueden utilizarse para ajustar una curva sigmoidea (en forma de S) a los datos. Esta curva suele observarse en la propagación de enfermedades infecciosas, ya que el número de casos normalmente aumenta despacio al principio, luego más rápido y después vuelve a desacelerarse a medida que la población alcanza la inmunidad de rebaño. Una ventaja de los modelos logísticos es que son relativamente sencillos de entender y de usar, y también pueden emplearse para predecir el curso de una epidemia. Sin embargo, los modelos logísticos no consideran todos los factores que pueden influir en la propagación de una enfermedad, como la tasa de contacto entre individuos y la efectividad de las intervenciones de salud pública [20, 21]. Los estudios que aplican la regresión logística se han adaptado con éxito a una amplia variedad de aplicaciones en la investigación sobre la COVID-19, entre ellas la evaluación de la gravedad clínica [22], el análisis de riesgos [23], el uso de vacunas [24] y la protección inmunitaria según los niveles de anticuerpos neutralizantes [25], lo que pone de relieve la versatilidad y la importancia de este tipo de modelo.
El objetivo de este estudio fue utilizar la regresión logística para modelar matemáticamente la dinámica de la COVID-19 en el Perú durante 30 meses de pandemia, abarcando los casos, las muertes y las personas vacunadas. Además, se evaluaron las posibles correlaciones entre los casos o las muertes y el número de personas vacunadas.
2. Materiales y métodos
2.1. Recolección de datos
Los datos brutos sobre infecciones, muertes y personas vacunadas en el Perú se obtuvieron del Panel de COVID-19 de la Organización Mundial de la Salud [3]. Estos datos abarcaron el periodo comprendido entre el 6 de marzo de 2020 y el 20 de marzo de 2023. Las variables de los datos incluyeron el total de casos, el total de muertes y las personas vacunadas.
Para describir el panorama epidemiológico de la COVID-19 en el Perú, graficamos la progresión de las variables de casos, muertes y personas vacunadas a lo largo del periodo seleccionado. Estas variables se definieron de la siguiente manera:
- Casos: total de casos confirmados de COVID-19. Los conteos pueden incluir casos probables, cuando se hayan notificado (del 6 de marzo de 2020 al 20 de marzo de 2023).
- Muertes: total de muertes atribuidas a la COVID-19. Los conteos pueden incluir muertes probables, cuando se hayan notificado (del 6 de marzo de 2020 al 20 de marzo de 2023).
- Personas vacunadas: número total de personas que recibieron al menos una dosis de vacuna (del 9 de febrero de 2021 al 20 de marzo de 2023).
Todos los datos están disponibles en el archivo suplementario (Tabla S1).
2.2. Modelamiento matemático
El modelamiento matemático se basó en la teoría de modelamiento empírico de Bronshtein y Semendiaev y se aplicó a la regresión logística para estimar la dinámica de los casos de COVID-19 en el Perú, abarcando casos, muertes y personas vacunadas. El modelo logístico se derivó del modelo logístico de Verhulst–Pearl, que describe un crecimiento inicialmente exponencial que se desacelera a medida que la población se aproxima a su capacidad de carga [26, 27].
La fórmula para calcular la dinámica de la COVID-19 en el Perú describe una dispersión logística de la siguiente forma:
\[N=\frac{M}{(1+Q\times e^{-k\times t})} \tag{1}\]
donde “\(M\)” es el número máximo de casos, muertes y personas vacunadas, “\(Q\)” es una cantidad preexponencial, “\(k\)” es una constante de proporcionalidad, “\(t\)” es el tiempo transcurrido (en días) y “\(N\)” es el número de casos, muertes y personas vacunadas, según corresponda.
La fórmula para calcular “\(M\)” para los tres eventos involucra tres valores aleatorios independientes y sus correspondientes valores dependientes de la base de datos, mediante la siguiente fórmula:
\[M=\frac{A\times B-I^{2}}{A+B-2I} \tag{2}\]
El primer valor (A) es el valor de la variable dependiente correspondiente a la variable independiente (\(t_{1}\)), donde el comportamiento presenta un punto de inflexión. Si el valor de inflexión (medio) obtenido no es un número entero, se toma el siguiente valor entero (por redondeo). Si este último valor no figura en la tabla de datos, se considera el siguiente valor mayor que aparezca—superior al valor obtenido—, incluido el valor vinculado.
El segundo valor (B) es el valor de la variable dependiente correspondiente al último valor de la variable independiente (\(t_{2}\)). El tercer valor (\(I\)) es el valor de la variable dependiente relacionado con la semisuma de las variables independientes \(t_{1}\) y \(t_{2}\), denotada por \(t_{3}=\frac{t_{1}+t_{2}}{2}\). Si el valor medio obtenido no es un número entero, se toma el siguiente valor entero (por redondeo) y se considera este último valor, incluido el valor vinculado.
El valor determinado de \(M\) se sustituye luego en el modelo logístico. Si el valor obtenido no es un número entero, se toma el siguiente valor entero (por redondeo). El modelo logístico se linealiza matemáticamente y se aplica el método de mínimos cuadrados para adoptar la forma \(\ln(\frac{M}{N}-1)lnQ+k\times t\); una ecuación lineal \(y=A+Cx\), donde \(y=\ln(\frac{M}{N}-1)\), \(x=t\) y \(A=lnQ\).
El proceso estadístico de regresión lineal puede realizarse introduciendo los pares ordenados \((x,y)\) en el formato \([(\frac{M}{N}-1)]\). Una vez introducidos todos los pares ordenados, se buscan lnQ y k. El valor de \(k\) es la pendiente de la ecuación lineal; es decir, el valor “\(C\)” en la ecuación lineal \(y=A+Cx\), donde el valor de \(A\) es \(lnB\) y, por lo tanto, \(Q=e^{A}\). Durante el mismo proceso de regresión lineal, evaluamos el estadístico de correlación “\(r\)” de Pearson. Para estimar las tasas de casos, muertes y personas vacunadas (personas/día) debidas a la COVID-19 en el Perú, derivamos el modelo logístico determinado, que adopta la siguiente forma:
\[\frac{dN}{dt}=\left[\frac{M\times Q\times k\times e^{-k\times t}}{{(1+Q\times e^{-k\times t})}^{2}}\right] \tag{3}\]
Para determinar el tiempo crítico (\(t_{c}\)) en el que el número de casos, muertes y personas vacunadas con respecto a la COVID-19 alcanzará su valor máximo, derivamos la Expresión (3), la igualamos a cero y despejamos el término:
\[t_{c}=-\frac{1}{k}\times \ln \left(\frac{1}{Q}\right) \tag{4}\]
Si el valor obtenido no es un número entero, se toma el siguiente valor entero (por redondeo) y se considera este último valor para estimar el valor buscado en el modelo original.
Utilizamos el paquete tidyverse en el lenguaje de programación \(R\) en el entorno de desarrollo integrado Rstudio IDE [28]. Tidyverse es un conjunto de paquetes de \(R\) diseñados para importar, transformar, visualizar y modelar la información utilizada en los procesos de ciencia de datos. Contiene el paquete ggplot2, utilizado para elaborar los gráficos de este artículo.
2.3. Análisis estadístico
Utilizamos los paquetes nortest y stats en el lenguaje de programación \(R\) dentro del entorno \(R\) Studio IDE. Nortest es una colección de funciones de \(R\) diseñadas específicamente para realizar pruebas de normalidad, mientras que stats abarca funciones de \(R\) dedicadas a pruebas estadísticas y análisis de datos. Se realizaron pruebas de correlación para evaluar si las vacunas reducen las infecciones y las muertes. Antes de realizar estas pruebas, se llevó a cabo una prueba de normalidad para cada población (casos, muertes y personas vacunadas).
Además, se utilizaron los paquetes tseries y lmtest porque proporcionan una serie de funciones específicas para el análisis de series de tiempo. Los datos recolectados se presentaron en forma de series de tiempo, ya que se trata de un proceso de conteo continuo de los nuevos valores diarios y de los valores acumulados de nuestras poblaciones. Las series de tiempo de cada una de nuestras poblaciones se sometieron a un análisis de estacionariedad y, posteriormente, se analizó la relación causal entre la dinámica de las personas infectadas y fallecidas con respecto a los vacunados.
2.3.1. Pruebas de normalidad para las variables: casos, muertes y personas vacunadas
Para evaluar si los datos de cada variable (casos, muertes y personas vacunadas) seguían una distribución normal, se realizaron pruebas de hipótesis. Estas pruebas proporcionan un valor p que representa la probabilidad de observar una distribución de datos similar o incluso más alejada de la normalidad, asumiendo que la hipótesis nula indica que la variable sigue una distribución normal perfecta en la población. Si el valor p supera el nivel de significancia, no hay evidencia suficiente para rechazar la hipótesis nula, lo que sugiere que la variable sigue una distribución normal [29]. Dado que los datos de cada población superaron \(N>50\), se aplicó la prueba de Kolmogorov–Smirnov mediante la función lillie.test del paquete nortest para cada población.
Prueba de hipótesis:
Los datos siguen una distribución normal.
Los datos no siguen una distribución normal.
Se estableció un nivel de significancia (α) de 0.05.
2.3.2. Prueba de correlación entre personas vacunadas y casos
Con base en los resultados de la prueba de normalidad, se realizó una prueba de correlación mediante el método de Spearman, ya que los datos de todas las poblaciones no seguían una distribución normal [30]. Para realizar la prueba se empleó la función cor.test (vaccinations, daily_cases, method = “spearman”).
Además, se utilizó la función cor (vaccinations, daily_cases, method = “spearman”) para visualizar el tipo de correlación (positiva o negativa), donde un valor de rho negativo indica una correlación negativa, mientras que un valor de rho positivo indica una correlación positiva.
Prueba de hipótesis:
Las variables no están correlacionadas.
Las variables están correlacionadas.
Se estableció un nivel de significancia (α) de 0.05.
Las pruebas de correlación se realizaron con datos reales y con datos modelados. Para los datos modelados, se emplearon los valores de cases_velocity en lugar de los de daily_cases.
2.3.3. Prueba de correlación entre personas vacunadas y muertes
Con base en los resultados de la prueba de normalidad, se realizó una prueba de correlación mediante el método de Spearman, ya que los datos de todas las poblaciones no seguían una distribución normal [30]. Para realizar la prueba se utilizó cor.test (people vaccinated, daily_deaths, method = “spearman”). Además, se empleó la función cor (people vaccinated, daily_deaths, method = “spearman”) para visualizar el tipo de correlación (positiva o negativa), donde un valor de rho negativo indica una correlación negativa, mientras que un valor de rho positivo indica una correlación positiva.
Prueba de hipótesis:
Las variables no están correlacionadas.
Las variables están correlacionadas.
Se estableció un nivel de significancia (α) de 0.05.
Las pruebas de correlación se realizaron con datos reales y con datos modelados. Para los datos modelados, se emplearon los valores de deaths_velocity en lugar de los de daily_deaths.
2.3.4. Pruebas de causalidad para las variables: casos, muertes y personas vacunadas
Con el fin de establecer una relación causal entre las variables de estudio (casos, muertes y vacunados), se realizó la prueba de causalidad de Granger. Se trata de una prueba de hipótesis que se utiliza para determinar si una serie de tiempo es estadística y significativamente útil para predecir el comportamiento de otra serie de tiempo [31–33].
Esta relación de causalidad, también conocida como causalidad de Granger, se debe a que una causa precede a un efecto y a que conocer cómo la historia de una serie de tiempo afecta la dinámica de la otra mejora su predicción; es decir, en sentido estricto, esta relación de causalidad se refiere a la precedencia y a la capacidad predictiva de una serie sobre otra. Por lo tanto, cuando afirmamos que una serie de tiempo X causa otra serie de tiempo Y “en el sentido de Granger”, queremos decir que X es un predictor estadísticamente significativo de Y [31, 32].
Esta prueba nos proporciona un valor p a partir del estadístico F; si su valor supera el nivel de significancia establecido, podemos rechazar la hipótesis nula, lo que sugiere que la serie de tiempo X es útil para la predicción de la serie Y. Las hipótesis y la regla de decisión utilizadas son las siguientes:
La serie de tiempo X no causa (en el sentido de Granger) la serie de tiempo Y.
La serie de tiempo X es un predictor causal de la serie de tiempo Y.
Se utilizó un nivel de significancia (α) de 0.05.
2.3.5. Pruebas de estacionariedad para las variables: casos, muertes y personas vacunadas
La prueba de causalidad de Granger requiere que las series de tiempo sean estacionarias. Para verificar este requisito, realizamos la prueba de Dickey–Fuller aumentada (ADF), que comprueba la estacionariedad entre un par de series de tiempo. Esta prueba analizó la estacionariedad en cada una de las series de tiempo estudiadas (casos, muertes y personas vacunadas). En esta prueba, si el valor p es menor que el nivel de significancia, se rechaza la hipótesis nula y se sugiere que la serie es estacionaria. Las hipótesis para evaluar una serie de tiempo X son las siguientes:
La serie de tiempo X no es estacionaria.
La serie de tiempo X es estacionaria.
Se utilizó un nivel de significancia (\(\alpha\)) de 0.05.
2.3.6. Criterios de información para determinar los órdenes de rezago
En la prueba de Granger, el rezago seleccionado se refiere al desfase temporal que se utilizará para predecir una serie de tiempo a partir de la otra. Por otro lado, el rezago en la prueba de Dickey–Fuller aumentada se refiere al número de rezagos en la diferencia de la serie de tiempo, que se utiliza para evaluar su estacionariedad. Por lo tanto, el rezago óptimo seleccionado para la prueba de Granger no puede utilizarse directamente en la prueba de Dickey–Fuller aumentada.
Tanto la prueba de causalidad de Granger como la prueba de Dickey–Fuller aumentada requieren que se especifique un valor de rezago. Para ello, se utilizaron el criterio de información de Akaike (AIC) y el criterio de información bayesiano (BIC). Estos criterios se emplean para comparar distintos modelos con diferentes valores de rezago y determinar cuál proporciona el mejor ajuste a los datos, ya que su desempeño depende del tamaño de la muestra y del orden de rezago [32, 34]. Los criterios de información penalizan los modelos más complejos en cuanto al número de rezagos incluidos [35]. Por lo tanto, al calcular estos criterios para varios valores de rezago, es posible identificar el modelo con el menor valor de AIC o BIC, lo que sugiere que es el modelo que mejor se ajusta a los datos; es decir, el valor de rezago que minimiza el AIC o el BIC es el que se considera óptimo según estos criterios.
2.3.7. Comparación de las variables modeladas con los datos reales
Para verificar si el modelo matemático explicaba el comportamiento de los datos reales, se calculó el coeficiente de determinación \(R^{2}\) [30]. \(R^{2}\) representa la proporción de la variabilidad total de la variable de respuesta explicada por el modelo. Un valor de \(R^{2}\) más cercano a 1 indica un buen ajuste del modelo, lo que sugiere que el modelo explica una gran parte de la variabilidad de la variable de respuesta. Por otro lado, un valor de \(R^{2}\) cercano a 0 indica que el modelo no explica adecuadamente la variabilidad de la variable de respuesta. Para calcular \(R^{2}\) se empleó la siguiente fórmula matemática: \(R^{2}=1-(SSR/SST)\), donde \(SSR\) (suma de cuadrados residual) es la suma de las diferencias al cuadrado entre los valores predichos por el modelo y los valores reales de la variable de respuesta, mientras que \(SST\) (suma de cuadrados total) es la suma de las diferencias al cuadrado entre los valores reales de la variable de respuesta y su media.
3. Resultados
3.1. Panorama epidemiológico de la COVID-19 en el Perú
El primer caso de COVID-19 en el Perú se confirmó el 6 de marzo de 2020. Desde entonces, el número de casos ha ido en aumento. Se observaron cinco olas epidemiológicas que alcanzaron o superaron los diez casos (infecciones) por cada mil, con picos alrededor de septiembre de 2020, abril de 2021, febrero y julio de 2022, y enero de 2023 (Figura 1).

En cuanto a las muertes, la progresión temporal de las muertes por COVID-19 en el Perú desde marzo de 2020 hasta marzo de 2023 se muestra en la Figura 2. El gráfico representa las tres olas de muerte diferenciadas. Cada ola se caracteriza por alcanzar o superar un umbral de 200 muertes diarias.
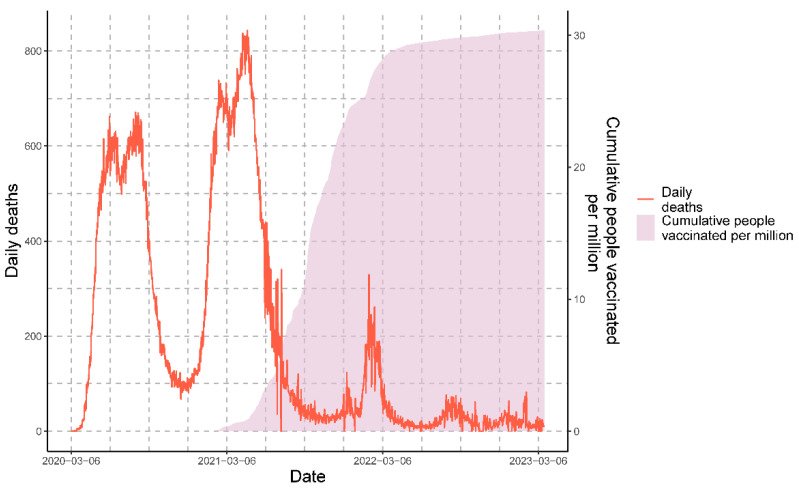
El proceso de vacunación en el Perú comenzó el 9 de febrero de 2021 y se han tomado en cuenta los datos sincrónicos desde el inicio de la pandemia de COVID-19 hasta el 20 de marzo de 2023. Los datos de nuevas vacunaciones diarias y acumuladas se muestran en la Figura 3. Este gráfico muestra distintos ciclos de vacunación, que se caracterizan por picos que superan las 100,000 vacunaciones diarias.

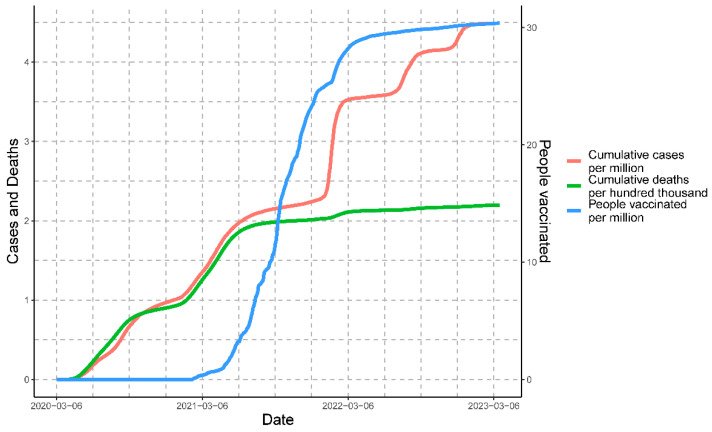
El escenario epidemiológico de los datos acumulados de las tres variables simultáneamente puede observarse en la Figura 4. El gráfico muestra la progresión temporal de los casos, las muertes y las personas vacunadas por COVID-19 en el Perú desde marzo de 2020 hasta marzo de 2023. El gráfico representa los casos acumulados y las personas vacunadas por millón, junto con las muertes acumuladas por cien mil.
3.2. Modelamiento matemático
Los parámetros obtenidos se resumieron empleando la metodología y los procedimientos descritos anteriormente (Tabla 1). La tabla muestra los valores de casos, muertes y personas vacunadas obtenidos mediante el modelo logístico.
| Parámetro | Casos | Muertes | Personas vacunadas |
|---|---|---|---|
| t1 | 642 | 343 | 222 |
| A | 2,245,146 | 110,184 | 15,348,800 |
| t2 | 1109 | 1109 | 769 |
| B | 4,489,377 | 219,648 | 30,374,977 |
| t3 | 876 | 726 | 496 |
| I | 3,889,029 | 210,672 | 29,526,095 |
| M | 4,834,759 | 220,528 | 30,429,043 |
| a | 4.1998 | 3.2259 | 3.5568 |
| Q | 66.673 | 25.176 | 35.051 |
| k | −0.0067 | −0.0083 | −0.0133 |
| tc | 627 | 389 | 268 |
| Velocidad máxima en tc | 8098 | 459 | 101,175 |
| Valor máximo en tc | 2,418,709 | 141,432 | 19,890,913 |
Los procedimientos detallados para aplicar el modelo a los casos, las muertes y las personas vacunadas se describen en las siguientes subsecciones:
3.2.1. Modelamiento matemático de los casos
El primer valor: \(t_{1}=642\) días; corresponde a \(A=2{,}245{,}146\) personas.
El segundo valor, \(t_{2}=1109\) días; corresponde a \(B=4{,}489{,}377\) personas.
El tercer valor: \(t_{3}=\frac{642+1109}{2}=872\) días; corresponde a \(I=3{,}889{,}092\) personas.
Ahora, reemplazando en (2): \(M=\frac{2{,}245{,}146\times 4{,}489{,}377-3{,}889{,}{029}^{2}}{2{,}245{,}146+4{,}489{,}377-2\times 3{,}889{,}029}=4{,}834{,}759\) personas.
Luego, el modelo \(Q=\frac{M}{(1+B\times e^{-k\times t})}\) puede escribirse como \(Q=\frac{4{,}874{,}759}{(1+B\times e^{-k\times t})}\).
Aplicando el método de mínimos cuadrados a la expresión \(\ln(\frac{4{,}834{,}759}{Q}-1)=A+k\times t\), podemos obtener el modelo de predicción o estimación.
\[Q=\frac{4{,}834{,}759}{(1+66.6730\times e^{-0.0067\times t})} \tag{5}\]
Con un coeficiente de correlación \(r=-0.8554\), y derivando la Ecuación (5), podemos obtener la ecuación de la velocidad de las personas infectadas, expresada por la Ecuación (6):
\[\frac{dQ}{dt}=\left[\frac{2{,}159{,}730.84\times e^{-0.0067\times t}}{{(1+66.6730\times e^{-0.0067\times t})}^{2}}\right] \tag{6}\]
Derivando la Ecuación (5) e igualando a cero, podemos determinar el tiempo crítico (tc) en el cual la velocidad de las personas infectadas es máxima.
\[t_{c}=-1/0.0067\ln\left(\frac{1}{66.6730}\right)=627\ \text{días} \tag{7}\]
Entonces, \(t_{c}=627\) días, y la velocidad máxima es \({\left(\frac{dN}{dt}\right)}_{\text{máx}}=8098\) personas/día (Figura 5).
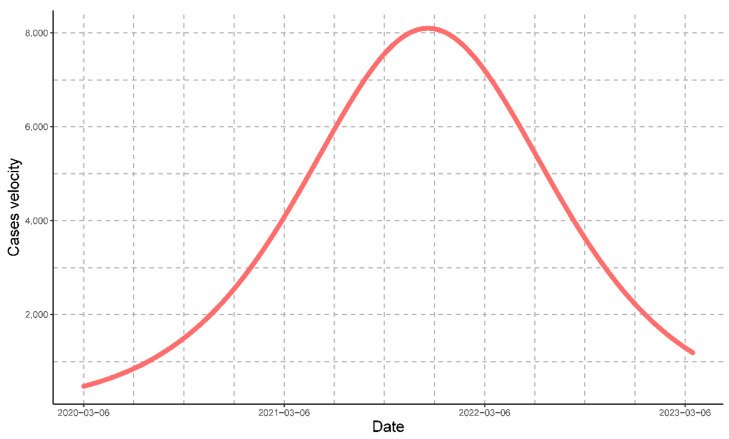
Para la COVID-19 en el Perú, la tasa máxima de casos estimados se dio el 23 de noviembre de 2021; el número de casos estimados se determinó mediante la Ecuación (5), y la tasa de cambio o tasa de casos estimados se determinó mediante la Ecuación (6).
3.2.2. Modelamiento matemático de las muertes
El primer valor: \(t_{1}=343\) días; corresponde a \(A=110{,}184\) personas.
El segundo valor: \(t_{2}=1109\) días; corresponde a \(A=219{,}648\) personas.
El tercer valor: \(t_{3}=\frac{343+1109}{2}=726\) días; corresponde a \(I=210{,}672\) personas.
Ahora, reemplazando en (2): \(M=\frac{110{,}184\times 219{,}684\ -\ 210{,}{672}^{2}}{110{,}184+219{,}684\ -\ 2\times 210{,}672}=220{,}528\) personas.
Luego, el modelo: \(Q=\frac{220{,}528}{(1+B\times e^{-k\times t})}\).
Aplicando el método de mínimos cuadrados a la expresión
\(\ln(\frac{220{,}528}{Q}-1)=A+k\times t\), podemos obtener el modelo de predicción o estimación:
\[Q=\frac{220{,}528}{(1+25.1760\times e^{-0.0083\times t})} \tag{8}\]
con un coeficiente de correlación \(r=-0.8902\). Derivando la Ecuación (7), podemos obtener la ecuación de la velocidad de las personas fallecidas, expresada por la Ecuación (8):
\[\frac{dQ}{dt}=\left[\frac{46{,}081.7073\times e^{-0.0083\times t}}{{(1+25.1760\times e^{-0.0083\times t})}^{2}}\right] \tag{9}\]
Derivando la Ecuación (7) e igualando a cero, podemos determinar el tiempo crítico (tc) en el cual la velocidad de las personas fallecidas es máxima.
\[t_{c}=-1/0.0083\ln\left(\frac{1}{25.1760}\right)=389\ \text{días} \tag{10}\]
Entonces, \(t_{c}=389\) días, y la velocidad máxima es \({\left(\frac{dN}{dt}\right)}_{\text{máx}}=459\) personas/día (Figura 6).
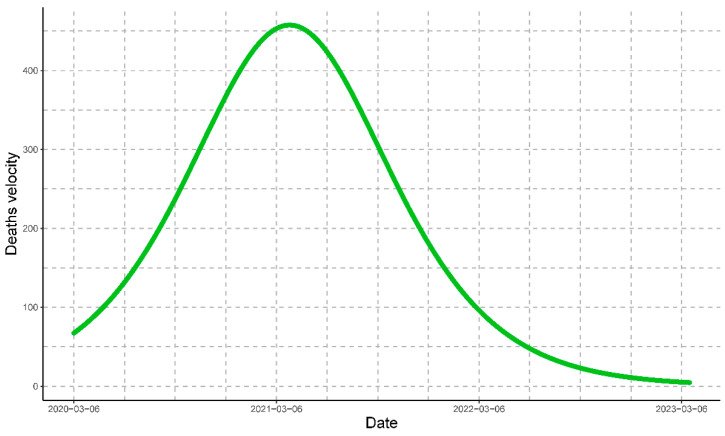
Para la COVID-19 en el Perú, la tasa máxima de muertes estimadas se dio el 30 de noviembre de 2021; el número de muertes estimadas se determinó mediante la Ecuación (7), y la tasa de cambio o tasa de muertes estimadas se determinó mediante la Ecuación (8).
3.2.3. Modelamiento matemático de las personas vacunadas
El primer valor: \(t_{1}=222\) días; corresponde a \(A=15{,}348{,}800\) personas.
El segundo valor: \(t_{2}=769\) días; corresponde a \(B=30{,}774{,}977\) personas.
El tercer valor: \(t_{3}=\frac{222+769}{2}=496\) días; corresponde a \(I=29{,}556{,}095\) personas.
Ahora, reemplazando en (2): \(M=\frac{15{,}348{,}800\times 30{,}774{,}977-29{,}556{,}{095}^{2}}{15{,}348{,}800+30{,}774{,}977-2\times 29{,}556{,}095}=30{,}429{,}043\) personas. Luego, el modelo \(Q=\frac{M}{(1+B\times e^{-k\times t})}\) puede escribirse como \(Q=\frac{30{,}429{,}043}{(1+B\times e^{-k\times t})}\).
Aplicando el método de mínimos cuadrados a la expresión
\(\ln(\frac{30{,}429{,}043}{Q}-1)=A+k\times t\), podemos obtener el modelo de predicción o estimación:
\[Q=\frac{30{,}429{,}043}{(1+35.0510\times e^{-0.0133\times t})} \tag{11}\]
con un coeficiente de correlación \(r=-0.722\). Derivando la Ecuación (9), podemos obtener la ecuación de la velocidad de las personas vacunadas, expresada mediante la Ecuación (10):
\[\frac{dQ}{dt}=\left[\frac{14{,}185{,}359.54\times e^{-0.0133\times t}}{{(1+35.0510\times e^{-0.0133\times t})}^{2}}\right] \tag{12}\]
Derivando la Ecuación (9) e igualando a cero, podemos determinar el tiempo crítico (\(t_{c}\)) en el que la velocidad de las personas vacunadas es máxima:
\[t_{c}=-1/0.0133\ln\left(\frac{1}{35.0510}\right)=268\ \text{días} \tag{13}\]
Luego, \(t_{c}=268\) días, y la velocidad máxima es \({\left(\frac{dN}{dt}\right)}_{\text{máx}}=101{,}175\) personas/día (Figura 7).
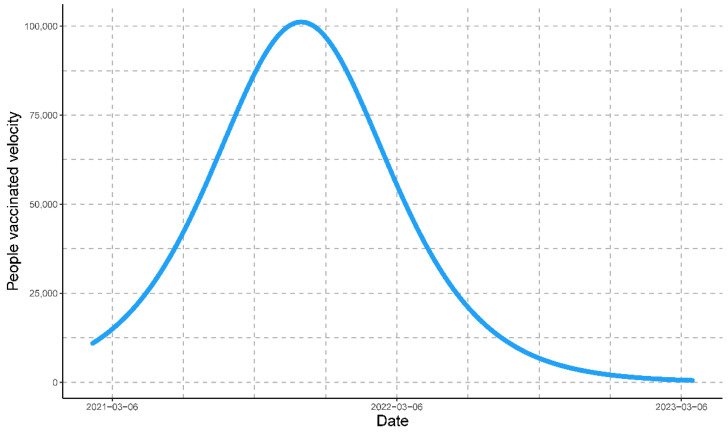
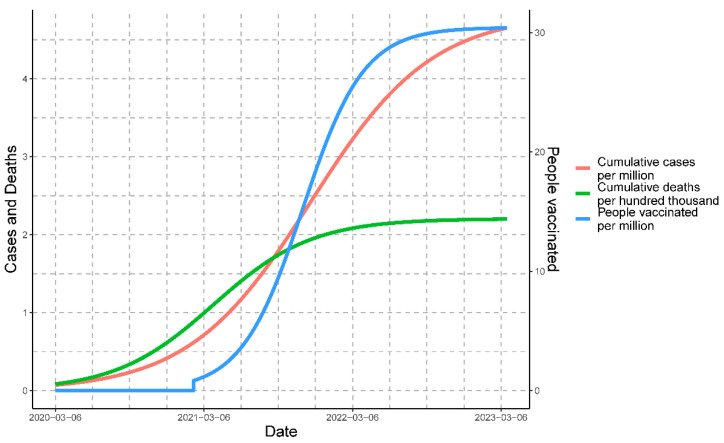
La tasa máxima estimada de personas vacunadas contra la COVID-19 en el Perú se registró el 4 de noviembre de 2021; el número estimado de personas vacunadas se determinó mediante la Ecuación (9), y la tasa de cambio estimada o tasa de personas vacunadas se determinó mediante la Ecuación (10). El escenario epidemiológico basado en los datos modelados para las tres variables de forma simultánea puede observarse en la Figura 8.
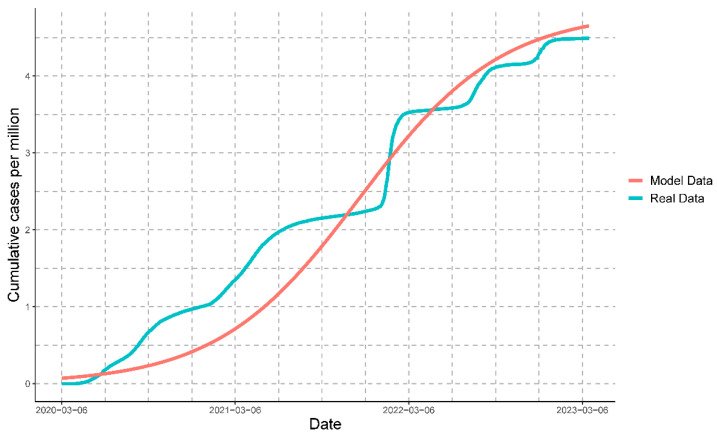
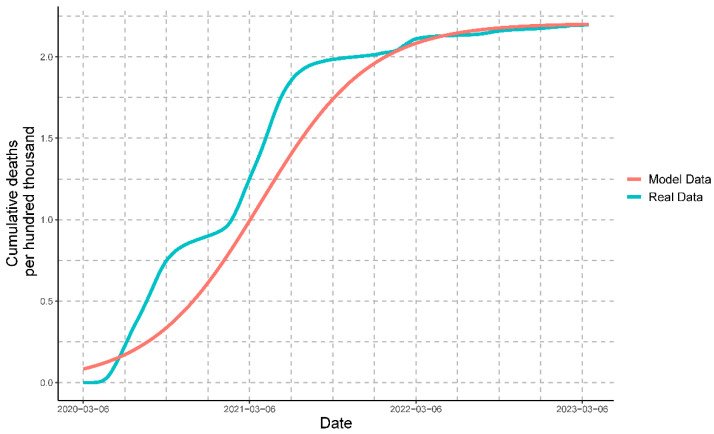
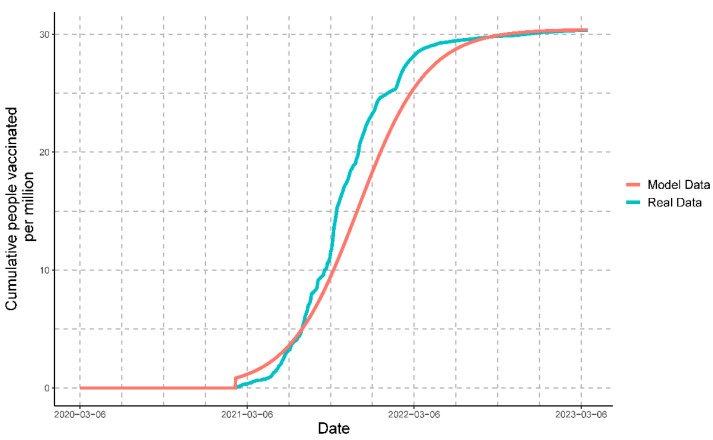
Una vez modeladas matemáticamente todas las variables, fue posible comparar la progresión de los datos reales con la de los datos modelados para los casos (Figura 9), las muertes (Figura 10) y las personas vacunadas (Figura 11).
3.3. Análisis estadístico
3.3.1. Pruebas de normalidad para las variables: casos, muertes y personas vacunadas
Los datos de las tres poblaciones (casos, muertes y personas vacunadas) no presentaron una distribución normal. El valor p para los datos de “personas vacunadas” fue \(<2.2\times {10}^{-16}\), lo que indica el rechazo de la hipótesis nula y que los datos no siguieron una distribución normal. El valor p para los datos de “casos” fue <2.2 × 10⁻¹⁶, lo que indica el rechazo de la hipótesis nula y que los datos no siguieron una distribución normal. El valor p para los datos de “muertes” fue \(<2.2\times {10}^{-16}\), lo que indica el rechazo de la hipótesis nula y que los datos no siguieron una distribución normal.
3.3.2. Prueba de correlación entre personas vacunadas y casos
La prueba de correlación se realizó para evaluar si el número de personas vacunadas influyó en la disminución del número de infecciones. Para los datos reales, el valor p obtenido fue \(<2.2\times {10}^{-16}\), por lo que se rechaza la hipótesis nula, lo que indica una correlación entre las variables. La función cor() arrojó un valor de rho de \(-0.4001837\), lo que indica una correlación negativa. Esta correlación negativa implica que un mayor número de personas vacunadas se corresponde con una disminución de los casos. Para los datos modelados, los resultados fueron similares; el valor p obtenido fue \(<2.2\times {10}^{-16}\), por lo que se rechaza la hipótesis nula, lo que indica una correlación entre las variables. La función cor() arrojó un valor de rho de \(-0.4204788\), lo que indica una correlación negativa. Esta correlación negativa implica que un mayor número de personas vacunadas se corresponde con una disminución de los casos.
3.3.3. Prueba de correlación entre personas vacunadas y muertes
La prueba de correlación se realizó para evaluar si el número de personas vacunadas influyó en la disminución de las muertes. Para los datos reales, el valor p fue <2.2 × 10⁻¹⁶, por lo que se rechaza la hipótesis nula, lo que indica una correlación entre las variables. La función cor() arrojó un valor de rho de \(-0.7530406\), lo que indica una correlación negativa. Esta correlación negativa implica que un mayor número de personas vacunadas conduce a una disminución de las muertes. Para los datos modelados, el valor p fue <2.2 × 10⁻¹⁶, por lo que se rechaza la hipótesis nula, lo que indica una correlación entre las variables. La función cor() arrojó un valor de rho de \(-0.9977608\), lo que indica una correlación negativa. Esta correlación negativa implica que un mayor número de personas vacunadas conduce a una disminución de las muertes.
Además, cabe señalar que el valor de rho obtenido en la prueba cor() realizada para las poblaciones de personas vacunadas y muertes fue menor que el valor de rho obtenido en la prueba cor() realizada para las personas vacunadas y los casos, lo que indica que la correlación negativa entre personas vacunadas y muertes fue más fuerte que la correlación negativa entre personas vacunadas y casos. Este resultado se obtuvo de manera similar tanto para los datos reales como para los datos modelados. Por lo tanto, aumentar el número de personas vacunadas tiene un mayor impacto en la reducción de las muertes que en la reducción de los casos.
3.3.4. Criterios de información para determinar los órdenes de rezago
Para determinar el orden de rezago de la prueba de estacionariedad de Dickey–Fuller aumentada, cada una de las series de tiempo (casos, muertes y personas vacunadas diarios) se sometió a distintos órdenes de rezago (de 1 a 25), y se obtuvieron los valores de AIC y BIC correspondientes a cada rezago, eligiéndose el menor de ellos. Estos resultados se muestran en la Tabla 2.
| Serie de tiempo | Orden de rezago (AIC) | Valor AIC | Orden de rezago (BIC) | Valor BIC |
|---|---|---|---|---|
| Personas vacunadas | 9 | 24,998.81 | 9 | 25,053.94 |
| Casos | 10 | 19,654.12 | 10 | 19,714.27 |
| Muertes | 16 | 10,476.19 | 15 | 10,562.1 |
Se seleccionaron los siguientes valores de orden de rezago para las series de tiempo de vacunados, casos y fallecidos: 9, 10 y 16, respectivamente.
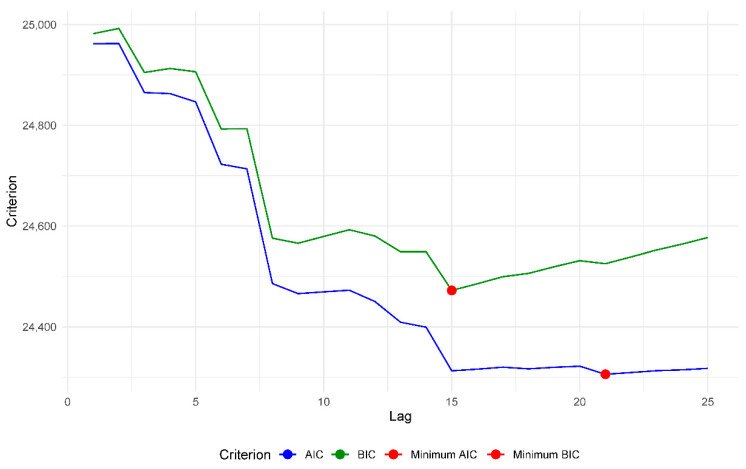
En el caso del orden de rezago para la prueba de causalidad de Granger, los valores mínimos de los criterios AIC y BIC encontrados se muestran en la Figura 12 y en la Tabla 3, y todos los valores encontrados para el orden de rezago van de 1 a 25 para la serie muertes–personas vacunadas.
| Par de series de tiempo | Orden de rezago (AIC) | Valor AIC | Orden de rezago (BIC) | Valor BIC |
|---|---|---|---|---|
| Muertes–personas vacunadas | 21 | 24,296.05 | 15 | 24,464.87 |
| Casos–personas vacunadas | 21 | 24,305.82 | 15 | 24,472.33 |
En este caso, seleccionamos un orden de rezago de 15 para ambos pares de series.
3.3.5. Pruebas de estacionariedad para las variables: casos, muertes y personas vacunadas
Las series de tiempo de las tres poblaciones (casos, muertes y personas vacunadas) pueden considerarse estacionarias. De acuerdo con la prueba de Dickey–Fuller aumentada con valores de orden de rezago de 9 (vacunados), 10 (casos) y 16 (muertes), utilizando la función adf.test() del paquete tseries, encontramos valores p < 0.01 (es decir, valores p < 0.05 (nivel de significancia)) para las tres poblaciones; por lo tanto, se rechaza la hipótesis nula y se establece que las tres series de tiempo son estacionarias, es decir, presentan una varianza constante en el tiempo.
3.3.6. Pruebas de causalidad entre las variables: casos, muertes y personas vacunadas
Dado que las tres series de tiempo fueron estacionarias, procedimos a realizar la prueba de causalidad de Granger para dos pares de series: casos–vacunados y muertes–vacunados. Analizamos ambas direcciones de causalidad en cada par de series con un orden de rezago de 15, utilizando la función grangertest (X, Y, order) del paquete lmtest; la siguiente tabla (Tabla 4) muestra los resultados:
| Par de series de tiempo | Muertes → Vacunados | Vacunados → Muertes | Casos → Vacunados | Vacunados → Casos |
|---|---|---|---|---|
| Valor p | 0.1828 | 0.01608 | 0.6495 | 0.9276 |
Debido a que el valor p en la dirección de causalidad vacunados → muertes es menor que el nivel de significancia (α = 0.05), se rechaza la hipótesis nula, es decir, los valores de las personas vacunadas pueden utilizarse para predecir los valores de las muertes. Las demás direcciones de causalidad mostraron un valor p > 0.05; en estos casos, no se puede rechazar la hipótesis nula, es decir, no existe causalidad de Granger entre ellas.
3.3.7. Comparación de las variables modeladas con los datos reales
La comparación de los datos reales con los datos obtenidos mediante el modelo matemático para casos, muertes y personas vacunadas dio como resultado los siguientes coeficientes de determinación (\(R^{2}\)): \(0.9263022\), \(0.9099109\) y \(0.9814848\), respectivamente. Estos valores indican que el modelo matemático representa fielmente los datos reales para todas las variables.
4. Discusión
La pandemia de COVID-19 fue una catástrofe sin precedentes debido a la aparición del primer coronavirus causante de una pandemia y a su propagación incontrolable, mitigada de manera significativa solo mediante el uso de vacunas. Otros factores sociales, políticos y económicos contemporáneos también influyeron en su impacto. La intrincada interacción de factores biológicos y no biológicos contribuyó significativamente a la transmisión y diseminación del SARS-CoV-2, lo que causó millones de casos y muertes en todo el mundo. Debido a la dinámica subyacente de la COVID-19, que presenta variaciones entre distintas regiones geográficas, nos propusimos emplear el modelamiento matemático, específicamente la regresión logística, para analizar la dinámica de la COVID-19 en el Perú durante tres años del periodo pandémico, abarcando casos, muertes y personas vacunadas. Además, evaluamos las posibles correlaciones entre los casos o las muertes y el número de personas vacunadas.
Predecir y comprender el comportamiento de las enfermedades infecciosas en epidemiología es fundamental para lograr intervenciones de salud pública y una formulación de políticas eficaces. Entre los diversos enfoques de modelamiento, el modelo matemático logístico ha demostrado ser valioso por su simplicidad, adaptabilidad y capacidad para capturar la dinámica esencial de la progresión de la enfermedad en una amplia gama de aplicaciones de investigación sobre la COVID-19 [22–25].
El modelamiento matemático, específicamente la regresión logística, ayuda a dilucidar la dinámica de la pandemia de COVID-19 en el Perú a lo largo de tres años, abarcando datos de casos, muertes y personas vacunadas. Esta investigación se justifica además por los desafíos singulares que plantea la COVID-19, como su rápida propagación mundial, su alta tasa de mutación y la aparición de variantes capaces de evadir la inmunidad. Si bien las vacunas han sido una herramienta fundamental para mitigar los efectos de la pandemia, las disparidades en su eficacia y la capacidad mutacional del virus hacen necesario un modelamiento integral para predecir tendencias futuras y orientar las estrategias de salud pública. Además, muchas publicaciones respaldan el uso del modelo logístico para predecir casos, muertes y vacunaciones por COVID-19 [36–40].
El enfoque de este estudio, basado en la teoría del modelamiento empírico, empleó la regresión logística para estimar la dinámica de los casos, las muertes y las personas vacunadas por COVID-19 en el Perú. La elección de un modelo logístico derivado del modelo logístico de Verhulst–Pearl es adecuada para capturar patrones de crecimiento que comienzan de forma exponencial pero se desaceleran a medida que se aproximan a una capacidad de carga [27]. Estos modelos son especialmente apropiados para la propagación de enfermedades infecciosas, en la que el crecimiento inicial es rápido pero se ralentiza a medida que entran en juego factores como la inmunidad de rebaño [14]. Las fórmulas detalladas, incluida la dispersión logística y el método para calcular los números máximos de casos, muertes y personas vacunadas, ofrecen un marco matemático integral. Sin embargo, como señalaron Kumari y Sharma [41], sería conveniente justificar la elección de parámetros y constantes específicos, de modo que los supuestos del modelo se ajusten a la dinámica real de la enfermedad.
En el modelo logístico, el tiempo crítico (tc) representa la velocidad máxima a la que la población experimenta infecciones, muertes o vacunaciones. También corresponde al punto de inflexión de la curva logística. A partir de este punto, la tasa de crecimiento de las tres poblaciones acumuladas comienza a disminuir, hasta estabilizarse finalmente en sus respectivos valores máximos (es decir, los números máximos de casos, muertes y personas vacunadas). Estos tiempos críticos tienen una enorme importancia, ya que marcan una reducción en la tasa de infección o de mortalidad, lo que indica que la epidemia comienza a estar bajo control. Es imperativo mantener las condiciones que favorecen esta tendencia, como el aumento de la atención primaria, la promoción de medidas preventivas contra el contagio, entre otras. Por el contrario, en el caso de las personas vacunadas, este punto crítico sugiere un cambio en la política de vacunación. La tasa de vacunación se ha ralentizado, lo que podría atribuirse a factores como la escasez de vacunas, la saturación de la población elegible u otras causas. Además, las implicaciones del uso de la vacunación en nuestro estudio nos ayudan a comprender mejor su impacto en la progresión de la pandemia. Esto puede aportar, de manera indirecta, información sobre la eficacia de las vacunas, la posible resistencia y la necesidad de dosis de refuerzo o de nuevas formulaciones. Dicho conocimiento puede influir en el desarrollo de vacunas, las estrategias de administración y la orientación a los pacientes. Desde una perspectiva más amplia de salud pública, estos hallazgos pueden orientar la planificación estratégica, la asignación de recursos y los esfuerzos de comunicación pública.
El uso en este estudio del lenguaje de programación R, y específicamente del paquete tidyverse, es encomiable [42]. Tidyverse es un conjunto de herramientas robusto para los procesos de ciencia de datos, y su inclusión garantiza un manejo y una visualización rigurosos de los datos. Sin embargo, como señalaron Mishra et al. [43], la sección de análisis estadístico podría beneficiarse de una exploración más profunda de las características de los datos antes de aplicar pruebas específicas. Si bien las pruebas de normalidad y las pruebas de hipótesis están bien estructuradas, sería ventajoso proporcionar algunas estadísticas descriptivas o visualizaciones preliminares para que los lectores comprendan con mayor claridad la distribución de los datos.
Las pruebas de correlación, centradas en la relación entre las personas vacunadas y los casos o las muertes, son cruciales para comprender el impacto de la vacuna. El método de Spearman es una elección adecuada dada la distribución no normal de los datos [30]. No obstante, sería conveniente discutir las implicaciones de los resultados de correlación en el contexto de la salud pública y de las estrategias de vacunación. El presente estudio identificó el impacto de las vacunaciones como correlaciones negativas entre las personas vacunadas y los casos o las muertes. Además, el efecto de las vacunaciones en la reducción de las muertes fue más pronunciado, al mostrar una correlación negativa más fuerte. La correlación relativa a los casos puede explicarse por el hecho de que las vacunas no previenen las infecciones, sino que más bien las mitigan, debido a la disminución gradual de los anticuerpos en las personas vacunadas y a las nuevas variantes del SARS-CoV-2 con características de evasión inmunitaria [11, 12]. Sin embargo, es importante señalar que la correlación solo muestra una relación recíproca entre dos variables y no implica causalidad.
Para determinar el efecto de causalidad entre dos variables se han desarrollado algunas estrategias estadísticas; por ejemplo, el emparejamiento por puntaje de propensión (PSM) se utiliza ampliamente en el contexto epidemiológico cuando se desea minimizar el sesgo de los estudios no aleatorizados y determinar los efectos de medidas de control o de tratamientos en las poblaciones de interés; sin embargo, esta metodología es aplicable esencialmente solo a estudios transversales y requiere variables de confusión o covariables para realizar un estudio robusto [44–48]. Además, se han implementado algunas metodologías para tratamientos o exposiciones variables en el tiempo, pero esta metodología podría ser inapropiada [49, 50]. Considerando la naturaleza de las variables abordadas en este estudio, implementamos la prueba de Granger para evaluar la causalidad. En general, si se conocen las variables relevantes y las relaciones entre ellas, y estas pueden formalizarse mediante modelos vectoriales autorregresivos (es decir, modelos que consideran las relaciones pasadas y presentes de las variables, generalmente representados como ecuaciones en diferencias), entonces la prueba de Granger puede ser útil para estudiar el nivel de predictibilidad de una variable a partir de otra [51]. Dado que nuestros datos tienen la forma de series de tiempo (es decir, valores discretos a intervalos regulares y finitos, y con características estacionarias), puede aplicarse la prueba de Granger. La prueba de causalidad de Granger nos permitió determinar, con significancia estadística, que la dinámica de la población vacunada puede utilizarse para pronosticar el comportamiento de las muertes. Sin embargo, la vacunación no parece tener un efecto directo sobre el contagio y la propagación de la enfermedad; esto es coherente con las características de las vacunas aplicadas en el Perú, que fueron diseñadas con el propósito de reducir la gravedad y, por lo tanto, la mortalidad, pero no el contagio de la enfermedad.
A pesar de lo anterior, debemos tener en cuenta que la prueba de causalidad utilizada no está libre de sesgos y que, incluso cuando se cumplen todos los requisitos para su aplicación, los resultados de la prueba de causalidad deben interpretarse en conjunto con los demás componentes del sistema (es decir, las variables y las relaciones entre ellas), además de que las relaciones no lineales entre variables tienden a disminuir su confiabilidad. Asimismo, no toma en cuenta el efecto de una tercera serie de tiempo que podría ser la verdadera causa del comportamiento observado al analizar pares de poblaciones [31, 33]. En el contexto de nuestro estudio, aunque se determinó un efecto predictivo de la dinámica de la población vacunada con respecto al número de muertes, no se estimó la magnitud de dicho efecto en comparación con otras medidas sanitarias, como la implementación de tratamiento farmacológico para pacientes sintomáticos, el aislamiento, el distanciamiento social, el uso de protectores mecánicos, los factores genéticos y conductuales, etc. Por otro lado, cabe mencionar que, dado que el modelo basado en ecuaciones diferenciales es un caso límite de las ecuaciones en diferencias, la causalidad en el sentido de Granger nos proporcionaría evidencia y un respaldo indirecto para expresar explícitamente esta relación en un modelo matemático de ecuaciones diferenciales con dos o más variables y, por lo tanto, extender el modelo logístico propuesto para caracterizar la dinámica de cada población.
Comparar las variables modeladas con los datos reales mediante el coeficiente de determinación, R2, es fundamental para validar la exactitud del modelo [52]. Un valor de R2 cercano a 1 sugeriría, en efecto, un buen ajuste, pero, como enfatizaron Härdle y Simar [53], es esencial interpretarlo en el contexto de la dinámica de la enfermedad. Incluso un modelo con un R2 alto podría tener limitaciones, sobre todo si no toma en cuenta factores externos como las intervenciones de salud pública o los cambios de comportamiento en la población. Sería conveniente contrastar el valor de R2 con otras métricas de bondad de ajuste y, quizás, comparar el desempeño del modelo logístico con otros posibles enfoques de modelamiento.
La naturaleza inherente del modelo logístico, que captura la curva sigmoidea (en forma de S) que suele observarse en la propagación de enfermedades infecciosas, lo convierte en una elección adecuada. El ascenso inicial lento, seguido de un aumento rápido y de una eventual meseta, refleja la progresión real de muchas epidemias, incluida la COVID-19 [54]. Esto resulta especialmente significativo dada la naturaleza impredecible de la propagación del virus, influida por factores como las intervenciones de salud pública, los cambios de comportamiento y las tasas de vacunación. La capacidad del modelo logístico para predecir la capacidad de carga potencial (es decir, el número máximo de casos, muertes o personas vacunadas) es útil para que los responsables de políticas y las autoridades sanitarias anticipen las necesidades de atención de salud y planifiquen estratégicamente las intervenciones.
Los modelos compartimentales complejos, como SIR, SEIR y SEIRD, ofrecen información detallada sobre la dinámica de la enfermedad, pero a menudo requieren muchos parámetros y supuestos. Por el contrario, el modelo logístico proporciona un enfoque sencillo para comprender la tendencia general de la epidemia sin adentrarse en las complejidades de la dinámica de transmisión de la enfermedad [14]. Esto lo convierte en una herramienta poderosa para evaluaciones y predicciones rápidas, especialmente cuando la toma oportuna de decisiones es primordial.
Si bien el modelo logístico ofrece muchas ventajas, es crucial reconocer sus limitaciones. El modelo asume de manera inherente un ascenso y un descenso simétricos, lo que podría no coincidir siempre con los datos reales, especialmente ante intervenciones externas o la aparición de nuevas variantes [20]. Además, el modelo no toma en cuenta factores como las tasas de contacto entre individuos o la efectividad de las medidas de salud pública. Por lo tanto, aunque el modelo logístico proporciona una visión general valiosa, idealmente debería utilizarse junto con otros modelos o fuentes de datos para comprender mejor la dinámica de la epidemia.
Los desafíos singulares que enfrentó el Perú durante la pandemia lo han convertido en un punto de atención para profesionales internacionales. El país presentó la razón infección–letalidad más alta del mundo durante los meses más catastróficos de la pandemia. Sumado a los desafíos derivados de las limitaciones de su sistema de salud, incluida la menor cantidad de respiradores mecánicos y de unidades de cuidados intensivos en la región, el Perú constituye un caso de estudio convincente sobre el manejo de un brote en circunstancias adversas. Las lecciones obtenidas del Perú pueden ser invaluables para naciones con una infraestructura sanitaria similar o que enfrentan desafíos externos parecidos. Además, comprender los efectos de la pandemia en poblaciones diversas, como la comunidad indígena amazónica del Perú, puede arrojar luz sobre la dinámica de la enfermedad en contextos socioculturales variados [55]. Estos hallazgos pueden orientar intervenciones adaptadas, la asignación de recursos y la formulación de políticas en otras regiones, lo que pone de relieve la relevancia universal de los estudios localizados [56].
5. Conclusiones
Este estudio concluye que el modelamiento matemático, en particular la regresión logística, constituyó una herramienta valiosa para analizar la dinámica de la COVID-19 en el Perú a lo largo de tres años, con énfasis en los casos, las muertes y las vacunaciones.
Los tiempos críticos identificados representaron las velocidades máximas de casos, muertes y vacunaciones, y señalaron un cambio en la dinámica de la epidemia hacia la estabilización. La importancia de estos puntos incide en la comprensión de la dinámica de la enfermedad, al permitir identificar los eventos ocurridos antes y después de dichas velocidades, lo que posibilita la adopción oportuna de medidas para un mejor control de la pandemia.
Se observaron correlaciones negativas entre el número de personas vacunadas y tanto los casos como las muertes, lo que indica una relación recíproca entre estas variables. Además, de acuerdo con la evidencia estadística, puede concluirse que la dinámica de la población vacunada es un buen predictor para determinar el comportamiento de las personas fallecidas; sin embargo, no pueden descartarse los efectos de otras variables (p. ej., el tratamiento farmacológico y las medidas no farmacológicas) como posibles predictores de las personas fallecidas.
Si bien el modelo logístico ofreció simplicidad y evaluaciones rápidas, presentó limitaciones inherentes al aplicarse a escenarios reales, como el supuesto de un ascenso simétrico y la omisión de variables más complejas o circunstanciales.
Finalmente, las lecciones derivadas de los desafíos singulares que enfrentó el Perú durante la pandemia, incluidas las deficiencias del sistema de salud y la diversidad de sus poblaciones, pueden aportar enseñanzas valiosas para países con una infraestructura similar o con desafíos externos parecidos. Esto puede orientar intervenciones adaptadas, la asignación de recursos y la formulación de políticas, lo que pone de relieve su relevancia universal.
Declaraciones
- Contribución de autores
- Conceptualización, O.M.-M., R.D.C. y O.M.-S.; metodología, O.M.-M., R.D.C., N.A.-L. y O.M.-S.; software, N.A.-L. y O.M.-S.; validación, N.A.-L. y O.M.-S.; análisis formal, O.M.-M., R.D.C., N.A.-L., L.P.-T., P.P.-G. y O.M.-S.; investigación, O.M.-M., R.D.C., N.A.-L., L.P.-T., P.P.-G. y O.M.-S.; curación de datos, R.D.C. y O.M.-S.; redacción—preparación del borrador original, O.M.-M., R.D.C., N.A.-L., L.P.-T., P.P.-G. y O.M.-S.; redacción—revisión y edición, O.M.-M., R.D.C., N.A.-L., L.P.-T., P.P.-G. y O.M.-S.; visualización, N.A.-L., L.P.-T., P.P.-G. y O.M.-S.; supervisión, R.D.C. y O.M.-S.; obtención de financiamiento, O.M.-M. y O.M.-S. Todos los autores han leído y aprobado la versión publicada del manuscrito.
- Financiamiento
- Esta investigación no recibió financiamiento externo para su ejecución. El Vicerrectorado de Investigación de la Universidad Nacional Federico Villareal (UNFV) financió el costo de publicación.
- Declaración ética
- Comité de ética institucional: No aplica.
Consentimiento informado: No aplica. - Conflicto de intereses
- Los autores declaran no tener ningún conflicto de intereses.
- Disponibilidad de datos y código
- Los datos brutos de infecciones, muertes y vacunaciones del Perú se obtuvieron del Panel de Control de la COVID-19 de la Organización Mundial de la Salud [3]. Estos datos abarcaron el periodo comprendido entre el 6 de marzo de 2020 y el 20 de marzo de 2023.
- Agradecimientos
- Deseamos agradecer a las siguientes dependencias de la Universidad Nacional Federico Villareal (UNFV): Vicerrectorado de Investigación, Dirección General de Administración, Oficina Central de Planificación y Oficina de Abastecimiento y Servicios Generales, por hacer posible el financiamiento del cargo por procesamiento del artículo (APC) en acceso abierto.
Referencias
- 1Zhu N., Zhang D., Wang W., Li X., Yang B., Song J., Zhao X., Huang B., Shi W., Lu R., et al. A Novel Coronavirus from Patients with Pneumonia in China, 2019. N. Engl. J. Med. 2020;382:727–733. doi:10.1056/NEJMoa2001017.
- 2Wu Z., McGoogan J.M. Characteristics of and Important Lessons from the Coronavirus Disease 2019 (COVID-19) Outbreak in China: Summary of a Report of 72314 Cases From the Chinese Center for Disease Control and Prevention. JAMA. 2020;323:1239–1242. doi:10.1001/jama.2020.2648.
- 3WHO Coronavirus (COVID-19) Dashboard. [(accessed on 20 March 2023)]. Available online: https://covid19.who.int/
- 4Kolahchi Z., De Domenico M., Uddin L.Q., Cauda V., Grossmann I., Lacasa L., Grancini G., Mahmoudi M., Rezaei N. COVID-19 and Its Global Economic Impact. Adv. Exp. Med. Biol. 2021;1318:825–837. doi:10.1007/978-3-030-63761-3_46.
- 5Markov P.V., Ghafari M., Beer M., Lythgoe K., Simmonds P., Stilianakis N.I., Katzourakis A. The Evolution of SARS-CoV-2. Nat. Rev. Microbiol. 2023;21:361–379. doi:10.1038/s41579-023-00878-2.
- 6Jiang X., Rayner S., Luo M.-H. Does SARS-CoV-2 Has a Longer Incubation Period than SARS and MERS? J. Med. Virol. 2020;92:476–478. doi:10.1002/jmv.25708.
- 7Guan W.-J., Ni Z.-Y., Hu Y., Liang W.-H., Ou C.-Q., He J.-X., Liu L., Shan H., Lei C.-L., Hui D.S.C., et al. Clinical Characteristics of Coronavirus Disease 2019 in China. N. Engl. J. Med. 2020;382:1708–1720. doi:10.1056/NEJMoa2002032.
- 8Lotfi M., Hamblin M.R., Rezaei N. COVID-19: Transmission, Prevention, and Potential Therapeutic Opportunities. Clin. Chim. Acta. 2020;508:254–266. doi:10.1016/j.cca.2020.05.044.
- 9Thanh Le T., Andreadakis Z., Kumar A., Gómez Román R., Tollefsen S., Saville M., Mayhew S. The COVID-19 Vaccine Development Landscape. Nat. Rev. Drug Discov. 2020;19:305–306. doi:10.1038/d41573-020-00073-5.
- 10Creech C.B., Walker S.C., Samuels R.J. SARS-CoV-2 Vaccines. JAMA. 2021;325:1318–1320. doi:10.1001/jama.2021.3199.
- 11Ghazy R.M., Ashmawy R., Hamdy N.A., Elhadi Y.A.M., Reyad O.A., Elmalawany D., Almaghraby A., Shaaban R., Taha S.H.N. Efficacy and Effectiveness of SARS-CoV-2 Vaccines: A Systematic Review and Meta-Analysis. Vaccines. 2022;10:350. doi:10.3390/vaccines10030350.
- 12Carabelli A.M., Peacock T.P., Thorne L.G., Harvey W.T., Hughes J., COVID-19 Genomics UK Consortium. Peacock S.J., Barclay W.S., de Silva T.I., Towers G.J., et al. SARS-CoV-2 Variant Biology: Immune Escape, Transmission and Fitness. Nat. Rev. Microbiol. 2023;21:162–177. doi:10.1038/s41579-022-00841-7.
- 13COVID-19 Forecasting Team Variation in the COVID-19 Infection-Fatality Ratio by Age, Time, and Geography during the Pre-Vaccine Era: A Systematic Analysis. Lancet. 2022;399:1469–1488. doi:10.1016/S0140-6736(21)02867-1.
- 14Bouchnita A., Chekroun A., Jebrane A. Mathematical Modeling Predicts That Strict Social Distancing Measures Would Be Needed to Shorten the Duration of Waves of COVID-19 Infections in Vietnam. Front. Public Health. 2020;8:559693. doi:10.3389/fpubh.2020.559693.
- 15Alanazi S.A., Kamruzzaman M.M., Alruwaili M., Alshammari N., Alqahtani S.A., Karime A. Measuring and Preventing COVID-19 Using the SIR Model and Machine Learning in Smart Health Care. J. Healthc. Eng. 2020;2020:8857346. doi:10.1155/2020/8857346.
- 16He S., Peng Y., Sun K. SEIR Modeling of the COVID-19 and Its Dynamics. Nonlinear Dyn. 2020;101:1667–1680. doi:10.1007/s11071-020-05743-y.
- 17Ghostine R., Gharamti M., Hassrouny S., Hoteit I. An Extended SEIR Model with Vaccination for Forecasting the COVID-19 Pandemic in Saudi Arabia Using an Ensemble Kalman Filter. Mathematics. 2021;9:636. doi:10.3390/math9060636.
- 18Loli Piccolomini E., Zama F. Monitoring Italian COVID-19 Spread by a Forced SEIRD Model. PLoS ONE. 2020;15:e0237417. doi:10.1371/journal.pone.0237417.
- 19Fonseca i Casas P., García i Carrasco V., Garcia i Subirana J. SEIRD COVID-19 Formal Characterization and Model Comparison Validation. Appl. Sci. 2020;10:5162. doi:10.3390/app10155162.
- 20Fang Y., Nie Y., Penny M. Transmission Dynamics of the COVID-19 Outbreak and Effectiveness of Government Interventions: A Data-Driven Analysis. J. Med. Virol. 2020;92:645–659. doi:10.1002/jmv.25750.
- 21Attanayake A.M.C.H., Perera S.S.N., Jayasinghe S. Phenomenological Modelling of COVID-19 Epidemics in Sri Lanka, Italy, the United States, and Hebei Province of China. Comput. Math. Methods Med. 2020;2020:6397063. doi:10.1155/2020/6397063.
- 22Wolter N., Jassat W., Walaza S., Welch R., Moultrie H., Groome M., Amoako D.G., Everatt J., Bhiman J.N., Scheepers C., et al. Early Assessment of the Clinical Severity of the SARS-CoV-2 Omicron Variant in South Africa: A Data Linkage Study. Lancet. 2022;399:437–446. doi:10.1016/S0140-6736(22)00017-4.
- 23Venancio-Guzmán S., Aguirre-Salado A.I., Soubervielle-Montalvo C., Jiménez-Hernández J.D.C. Assessing the Nationwide COVID-19 Risk in Mexico through the Lens of Comorbidity by an XGBoost-Based Logistic Regression Model. Int. J. Environ. Res. Public Health. 2022;19:11992. doi:10.3390/ijerph191911992.
- 24Shmueli L. Predicting Intention to Receive COVID-19 Vaccine among the General Population Using the Health Belief Model and the Theory of Planned Behavior Model. BMC Public Health. 2021;21:804. doi:10.1186/s12889-021-10816-7.
- 25Khoury D.S., Cromer D., Reynaldi A., Schlub T.E., Wheatley A.K., Juno J.A., Subbarao K., Kent S.J., Triccas J.A., Davenport M.P. Neutralizing Antibody Levels Are Highly Predictive of Immune Protection from Symptomatic SARS-CoV-2 Infection. Nat. Med. 2021;27:1205–1211. doi:10.1038/s41591-021-01377-8.
- 26Kot M. Elements of Mathematical Ecology. 1st ed. Cambridge University Press; Cambridge, UK: 2001. pp. 3–12.
- 27Bacaër N. Verhulst and the Logistic Equation (1838) In: Bacaër N., editor. A Short History of Mathematical Population Dynamics. 1st ed. Springer; London, UK: 2011. pp. 35–39.
- 28Wickham H., Bryan J. R Packages. 2nd ed. O’Reilly Media, Inc.; Sebastopol, CA, USA: 2023. pp. 1–381.
- 29Pereira S.M.C., Leslie G. Hypothesis Testing. Aust. Crit. Care. 2009;22:187–191. doi:10.1016/j.aucc.2009.08.003.
- 30Schober P., Boer C., Schwarte L.A. Correlation Coefficients: Appropriate Use and Interpretation. Anesth. Analg. 2018;126:1763–1768. doi:10.1213/ANE.0000000000002864.
- 31Amblard P.-O., Michel O.J.J. The Relation between Granger Causality and Directed Information Theory: A Review. Entropy. 2013;15:113–143. doi:10.3390/e15010113.
- 32Bruns S.B., Stern D.I. Lag Length Selection and P-Hacking in Granger Causality Testing: Prevalence and Performance of Meta-Regression Models. Empir. Econ. 2019;56:797–830. doi:10.1007/s00181-018-1446-3.
- 33Stokes P.A., Purdon P.L. A Study of Problems Encountered in Granger Causality Analysis from a Neuroscience Perspective. Proc. Natl. Acad. Sci. USA. 2017;114:E7063–E7072. doi:10.1073/pnas.1704663114.
- 34Cheung Y.-W., Lai K.S. Lag Order and Critical Values of the Augmented Dickey-Fuller Test. J. Bus. Econ. Stat. 1995;13:277–280. doi:10.2307/1392187.
- 35Kihoro J.M., Otieno R.O., Wafula C. Seasonal Time Series Forecasting: A Comparative Study of Arima and Ann Models. Afr. J. Sci. Technol. 2004;5:41–49. doi:10.4314/ajst.v5i2.15330.
- 36Jewell N.P., Lewnard J.A., Jewell B.L. Predictive Mathematical Models of the COVID-19 Pandemic: Underlying Principles and Value of Projections. JAMA. 2020;323:1893–1894. doi:10.1001/jama.2020.6585.
- 37Hsiang S., Allen D., Annan-Phan S., Bell K., Bolliger I., Chong T., Druckenmiller H., Huang L.Y., Hultgren A., Krasovich E., et al. The Effect of Large-Scale Anti-Contagion Policies on the COVID-19 Pandemic. Nature. 2020;584:262–267. doi:10.1038/s41586-020-2404-8.
- 38Chimmula V.K.R., Zhang L. Time Series Forecasting of COVID-19 Transmission in Canada Using LSTM Networks. Chaos Solitons Fractals. 2020;135:109864. doi:10.1016/j.chaos.2020.109864.
- 39Anastassopoulou C., Russo L., Tsakris A., Siettos C. Data-Based Analysis, Modelling and Forecasting of the COVID-19 Outbreak. PLoS ONE. 2020;15:e0230405. doi:10.1371/journal.pone.0230405.
- 40Petropoulos F., Makridakis S. Forecasting the Novel Coronavirus COVID-19. PLoS ONE. 2020;15:e0231236. doi:10.1371/journal.pone.0231236.
- 41Kumari N., Sharma S. Modeling the Dynamics of Infectious Disease under the Influence of Environmental Pollution. Int. J. Appl. Comput. Math. 2018;4:84. doi:10.1007/s40819-018-0514-x.
- 42Wickham H., Averick M., Bryan J., Chang W., McGowan L.D., François R., Grolemund G., Hayes A., Henry L., Hester J. Welcome to the Tidyverse. J. Open Source Softw. 2019;4:1686. doi:10.21105/joss.01686.
- 43Mishra P., Pandey C.M., Singh U., Gupta A., Sahu C., Keshri A. Descriptive Statistics and Normality Tests for Statistical Data. Ann. Card. Anaesth. 2019;22:67–72. doi:10.4103/aca.ACA_157_18.
- 44Walzer P., Estève C., Barben J., Menu D., Cuenot C., Manckoundia P., Putot A. Impact of Influenza Vaccination on Mortality in the Oldest Old: A Propensity Score-Matched Cohort Study. Vaccines. 2020;8:356. doi:10.3390/vaccines8030356.
- 45Shiba K., Kawahara T. Using Propensity Scores for Causal Inference: Pitfalls and Tips. J. Epidemiol. 2021;31:457–463. doi:10.2188/jea.JE20210145.
- 46Zhong H., Li W., Boarnet M.G. A Two-Dimensional Propensity Score Matching Method for Longitudinal Quasi-Experimental Studies: A Focus on Travel Behavior and the Built Environment. Environ. Plan. B Urban Anal. City Sci. 2021;48:2110–2122. doi:10.1177/2399808320982305.
- 47Hardgrave H., Wells A., Nigh J., Klutts G., Krinock D., Osborn T., Bhusal S., Rude M.K., Burdine L., Giorgakis E. COVID-19 Mortality in Vaccinated vs. Unvaccinated Liver & Kidney Transplant Recipients: A Single-Center United States Propensity Score Matching Study on Historical Data. Vaccines. 2022;10:1921. doi:10.3390/vaccines10111921.
- 48Son C.-S., Jin S.-H., Kang W.-S. Propensity-Score-Matched Evaluation of Adverse Events Affecting Recovery after COVID-19 Vaccination: On Adenovirus and mRNA Vaccines. Vaccines. 2022;10:284. doi:10.3390/vaccines10020284.
- 49Zhang Z., Li X., Wu X., Qiu H., Shi H., AME Big-Data Clinical Trial Collaborative Group Propensity Score Analysis for Time-Dependent Exposure. Ann. Transl. Med. 2020;8:246. doi:10.21037/atm.2020.01.33.
- 50Wijn S.R.W., Rovers M.M., Hannink G. Confounding Adjustment Methods in Longitudinal Observational Data with a Time-Varying Treatment: A Mapping Review. BMJ Open. 2022;12:e058977. doi:10.1136/bmjopen-2021-058977.
- 51Asghar Z. Simulation Evidence on Granger Causality in Presence of a Confounding Variable. Int. J. Appl. Econom. Quant. Stud. 2008;5:71–86.
- 52Chicco D., Warrens M.J., Jurman G. The Coefficient of Determination R-Squared Is More Informative than SMAPE, MAE, MAPE, MSE and RMSE in Regression Analysis Evaluation. PeerJ Comput. Sci. 2021;7:e623. doi:10.7717/peerj-cs.623.
- 53Härdle W.K., Simar L. Conjoint Measurement Analysis. In: Härdle W.K., Simar L., editors. Applied Multivariate Statistical Analysis. 2nd ed. Springer; Berlin, Germany: 2015. pp. 473–486.
- 54Mishra B.K., Keshri A.K., Saini D.K., Ayesha S., Mishra B.K., Rao Y.S. Mathematical Model, Forecast and Analysis on the Spread of COVID-19. Chaos Solitons Fractals. 2021;147:110995. doi:10.1016/j.chaos.2021.110995.
- 55Soto-Cabezas M.G., Reyes M.F., Soriano A.N., Rodríguez J.P.V., Ibargüen L.O., Martel K.S., Jaime N.F., Munayco C.V. COVID-19 among Amazonian Indigenous in Peru: Mortality, Incidence, and Clinical Characteristics. J. Public Health. 2022;44:e359–e365. doi:10.1093/pubmed/fdac058.
- 56Grillo Ardila E.K., Santaella-Tenorio J., Guerrero R., Bravo L.E. Mathematical Model and COVID-19. Colomb. Med. 2020;51:e4277. doi:10.25100/cm.v51i2.4277.
Material suplementario
Cómo citar este artículo
Marín-Machuca, O., Chacón, R. D., Alvarez-Lovera, N., Pesantes-Grados, P., Pérez-Timaná, L., & Marín-Sánchez, O. (2023). Modelamiento matemático de los casos y las muertes por COVID-19 y del impacto de la vacunación durante tres años de pandemia en el Perú. Vaccines, 11(11), 1648. https://doi.org/10.3390/vaccines11111648
Artículo de acceso abierto bajo licencia CC BY 4.0. © 2023 Los autores. Publicado originalmente por MDPI en Vaccines; reproducido en la LYN BIOLEARNING – Biblioteca Científica según los términos de la licencia.
Comentarios
Aún no hay comentarios. ¿Tienes una pregunta o un aporte? Sé el primero en comentar.